Os documentos que utiliza para avaliar um analisador devem ser selecionados entre os tipos de documentos normalmente utilizados no dia a dia da sua organização. O seu conjunto de testes deve incluir, no mínimo:
- Documentos digitalizados: Imagens de documentos em papel, com diferentes níveis de qualidade de digitalização, inclinação e ruído. É aqui que a qualidade do reconhecimento ótico de caracteres (OCR) distingue os analisadores de nível comercial das ferramentas de código aberto, como o Tesseract.
- Layouts com várias colunas: Relatórios financeiros, artigos académicos e boletins informativos que apresentam texto em colunas paralelas. Os analisadores que não conseguem detetar os limites das colunas misturam o conteúdo de colunas adjacentes, produzindo segmentos que são, na realidade, incoerentes.
- Tabelas complexas: Tabelas sem bordas, células unidas e tabelas que se estendem por várias páginas. A conversão de tabelas numa estrutura linear é um dos modos de falha silenciosa mais comuns em ambiente de produção.
- Conteúdo multilingue: Documentos que combinam vários idiomas ou utilizam sistemas de escrita não latinos, como o árabe, o chinês, o japonês e o coreano. A cobertura varia significativamente entre os analisadores sintáticos. A ABBYY suporta 208 idiomas; ao passo que muitas ferramentas de código aberto ficam muito aquém desse número.
- Documentos longos, com várias páginas: Contratos, manuais técnicos e relatórios em que as hierarquias de secções se estendem por dezenas ou centenas de páginas. A ordem de leitura e a continuidade estrutural nas quebras de página são pontos de falha frequentes.
- Estrutura inconsistente: Os documentos reais não são coerentes. Os cabeçalhos aparecem em sítios inesperados. As notas de rodapé interrompem o corpo do texto. Os documentos que, à primeira vista, parecem estruturados apresentam frequentemente irregularidades que confundem os analisadores sintáticos treinados para formatos bem definidos.
Avalie a forma como o analisador lida com a ambiguidade estrutural, e não apenas com documentos com uma formatação clara e consistente. Sem um conjunto de testes realista que inclua estes tipos de documentos, a sua avaliação está a medir condições de demonstração, e não a realidade da produção.
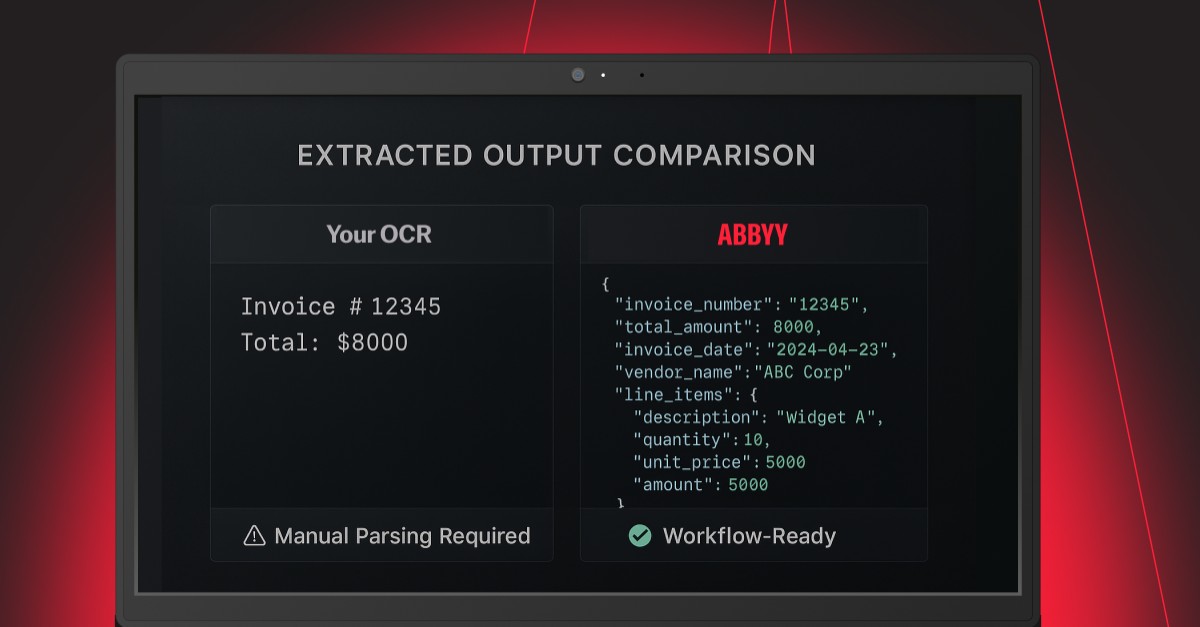
A precisão ao nível dos caracteres, ou seja, a percentagem de caracteres extraídos corretamente, pouco nos diz sobre se um analisador será capaz de suportar uma recuperação RAG fiável. Um analisador pode atingir uma elevada precisão ao nível dos caracteres, ao mesmo tempo que destrói completamente a estrutura de informação de que o seu sistema a jusante necessita.
Teste cada um dos seguintes itens:
- Preservação da estrutura: Os títulos, as secções e a hierarquia do documento estão corretamente identificados e rotulados? A segmentação que respeita a estrutura real do documento proporciona uma recuperação mais eficaz do que uma segmentação baseada em limites estimados.
- Ordem de leitura: O texto extraído está na ordem que um leitor seguiria? Os documentos com várias colunas e os layouts complexos levam frequentemente os analisadores a apresentar o texto numa sequência errada.
- Fidelidade das tabelas: As relações entre linhas e colunas são mantidas no resultado final? Uma tabela que é transformada numa cadeia de texto perde as relações que lhe conferem significado para um modelo a jusante.
- Relações entre campos e rótulos: Nos formulários e documentos estruturados, o analisador associa corretamente os valores dos campos aos respetivos rótulos? Os valores dissociados são uma fonte comum de erros factuais nos resultados da RAG.
- Utilidade do formato de saída: O formato de saída contém informação semântica suficiente para que a segmentação e a recuperação funcionem corretamente? O texto simples retira o contexto que torna a recuperação precisa.
Um formato estruturado como o DocLang, que foi criado em colaboração pela ABBYY com a IBM, a Nvidia, a Red Hat e a Linux Foundation como um padrão aberto de marcação de documentos nativo de IA, inclui etiquetas semânticas para títulos, parágrafos, células de tabelas, notas de rodapé e campos de formulário. É essa estrutura que torna o resultado verdadeiramente preparado para IA.
.
O desempenho em laboratório corresponde aos resultados obtidos por um analisador num benchmark cuidadosamente preparado. O desempenho operacional é o que o sistema faz com os seus documentos, com o seu volume e dentro das suas limitações.
Os analisadores mais eficazes são aqueles que produzem estruturas de dados eficientes e previsíveis em diversos tipos de documentos, tendo a avaliação de ir além da mera precisão do OCR para medir a compreensão semântica.
Existe uma categoria de resultados de avaliação que causa problemas reais: "é suficiente para a maioria dos documentos."
A questão não é se o seu analisador processa bem documentos sem problemas; é, antes, se consegue processar todo o seu corpus de forma fiável sem introduzir erros que se propaguem ao longo do pipeline.
A ideia de "suficientemente bom" não tem em conta o efeito cumulativo dos erros parciais. Um analisador que extrai corretamente 98% do conteúdo de um documento, mas que simplifica sistematicamente todas as tabelas, pode produzir resultados úteis para a maioria das consultas, embora falhe completamente em qualquer consulta que exija dados de tabelas. O valor de precisão global de 98% não reflete a taxa de falha de 100% nas consultas dependentes de tabelas.
Se esses erros envolverem termos financeiros essenciais, datas ou cláusulas de responsabilidade, as consequências nas fases subsequentes não são meramente abstratas.
É por isso que a avaliação específica dos tipos de documentos e das características estruturais é o mais importante para o seu caso de utilização. Se o seu pipeline depender da extração de tabelas, avalie especificamente a fidelidade das tabelas. Se processar documentos multilingues, avalie a precisão em cada idioma. Se depender da hierarquia de secções para a segmentação, avalie se os limites das secções estão corretamente identificados.
Os documentos mais difíceis revelam o limite máximo.
Uma comparação direta fornece-lhe os dados mais úteis para tomar medidas. Execute o mesmo conjunto de documentos no seu analisador atual e no analisador que está a avaliar e, em seguida, compare os resultados lado a lado nas dimensões que são relevantes para o seu pipeline.
Mais concretamente:
- Passo 1: Selecione um conjunto de referência com 50 a 100 documentos. Dê prioridade aos documentos complexos e desafiantes do seu corpus real, e não aos mais fáceis.
- Passo 2: Analise cada documento com ambas as ferramentas. Guarde o resultado completo para uma análise posterior.
- Passo 3: Selecione uma amostra de 10 a 20 documentos para inspecionar manualmente a estrutura, a ordem de leitura e a fidelidade das tabelas. Evite basear-se exclusivamente em métricas ao nível dos caracteres, uma vez que estas não revelam as falhas estruturais que mais afetam o desempenho.
- Passo 4: Faça um teste de recuperação, preparando um conjunto de perguntas cujas respostas já conhece e que se encontram nos seus documentos. Indexe os resultados analisados de cada ferramenta e avalie se a recuperação apresenta as passagens corretas.
- Passo 5: Compare os formatos de saída para determinar se o formato do seu analisador atual contém estrutura semântica suficiente para que a sua lógica de segmentação funcione corretamente. Caso contrário, considere um formato como o DocLang, com rotulagem semântica, que pode melhorar significativamente os resultados de segmentação e recuperação.
O objetivo não é encontrar um analisador que obtenha uma pontuação mais elevada numa tabela de classificação. O objetivo é encontrar um analisador que produza melhores resultados no seu pipeline específico, com os seus documentos específicos.
A forma mais rápida de compreender o limite de produção de um analisador é submeter-lhe, em primeiro lugar, os documentos mais complexos. Aqueles que, neste momento, estão a causar problemas no seu pipeline. Aqueles que geram alucinações, tabelas danificadas ou uma ordem de leitura confusa.
Com o FineParser powered by ABBYY, pode descarregar o contentor Docker, executá-lo nos documentos que já estão a causar problemas e comparar a resultado estruturado com o que o seu analisador atual produz.
A diferença entre os resultados devolvidos pelo seu analisador e pelo que preserva a estrutura dir-lhe-á mais sobre o limite máximo de fiabilidade do seu pipeline do que qualquer resultado de benchmark.
Experimente o ABBYY nos seus documentos reais; o acesso antecipado já está disponível.

