Potencie la automatización con IA con la ayuda de un OCR fiable y preciso
Optimice el procesamiento directo de documentos con información basada en datos
Integre la fiable Document AI en sus flujos de trabajo de automatización con tan solo unas líneas de código
COMPRENSIÓN DEL PROCESO
OPTIMIZACIÓN DE PROCESOS
IA específica para una automatización sin límites.
Ponga en marcha la automatización con modelos IA de extracción preentrenados .
Conocer a nuestros colaboradores, explorar recursos y mucho más.
POR INDUSTRIA
POR PROCESO DE NEGOCIO
POR TECNOLOGÍA
CONSTRUYA
Integre el reconocimiento de texto avanzado en sus aplicaciones mediante una API.
Infraestructura de análisis de documentos para flujos de IA.
Datos de documentos optimizados para IA que generan resultados contextualizados con GenAI y RAG (generación aumentada por recuperación).
Descubre la IA especializada de ABBYY para la automatización inteligente.
CREZCA
Conecte con profesionales experimentados en OCR, IDP e IA.
Un disntinguido reconocimiento que se les concede a los desarrolladores que demuestran una experiencia excepcional en ABBYY AI.
EXPLORAR
PERSPECTIVAS
Servicios
Salida de datos

La combinación de una plataforma de procesamiento inteligente de documentos (IDP) específica con la flexibilidad de los grandes modelos de lenguaje (LLM) le permite ir más allá de la extracción de datos estándar. Este enfoque híbrido permite funciones avanzadas como la síntesis, el razonamiento contextual y la comunicación automatizada. Integrar un LLM de su elección con el IDP le permite mejorar sus flujos de trabajo de documentos existentes, manejar contenido no estructurado con mayor precisión y alcanzar nuevos niveles de eficiencia, todo ello en un entorno seguro, controlado y escalable.
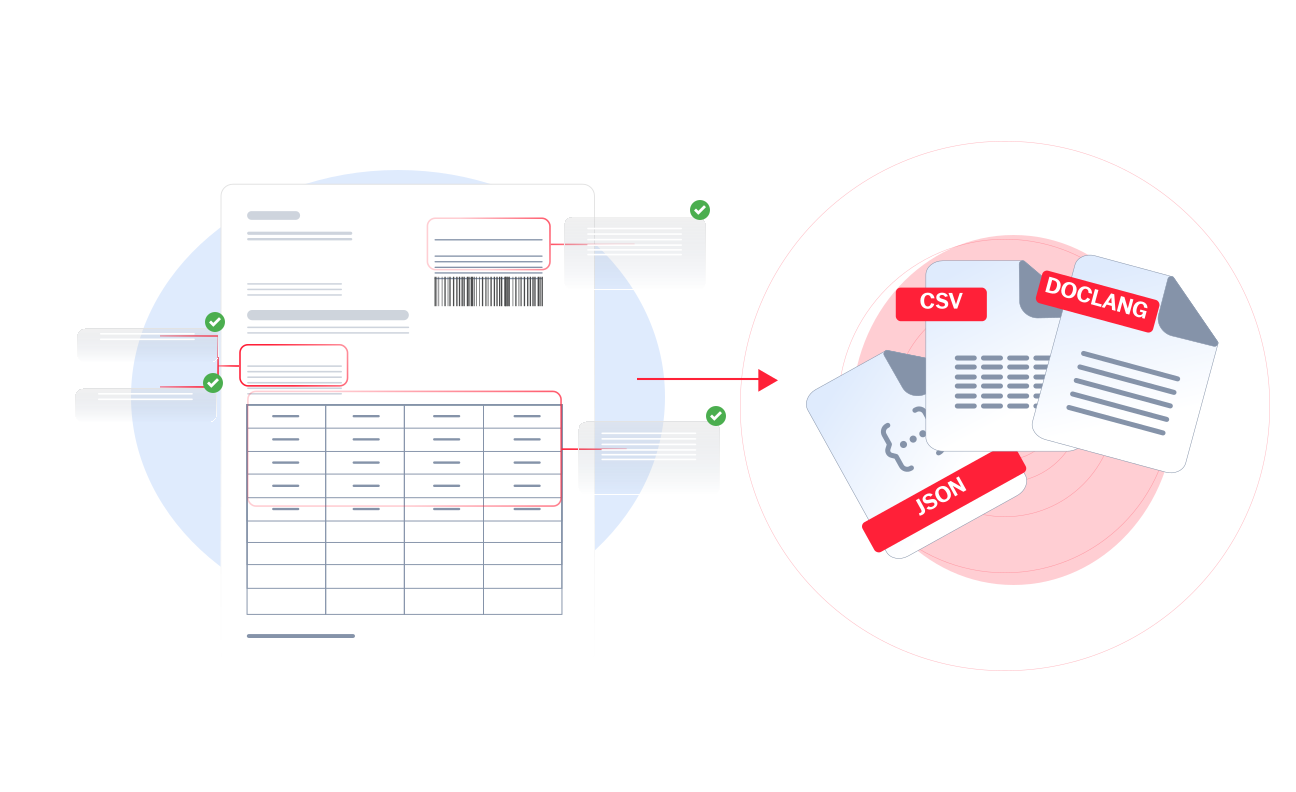
Exportaciones estructuradas de datos de campo en formato JSON o CSV, depuradas, validadas y listas para su uso inmediato en sistemas ERP, bases de datos o flujos de trabajo de agentes.
DocLang proporciona una representación legible por máquina del documento completo, que incluye metadatos sobre la estructura, el diseño y la gobernanza, de modo que los modelos de lenguaje grande (LLM) y los agentes de IA trabajen a partir de datos verificados, y no de aproximaciones deducidas.
El texto reconocido se exporta a DOCX, XLSX, HTML y otros formatos editables, conservando la estructura original del documento.
Las imágenes procesadas se exportan como archivos PDF con función de búsqueda y PDF/A para su recuperación y archivo a largo plazo, y se envían directamente a SharePoint o a un almacenamiento compartido. Los campos confidenciales pueden ocultarse de forma permanente antes de la exportación cuando así lo exijan las normas de cumplimiento.

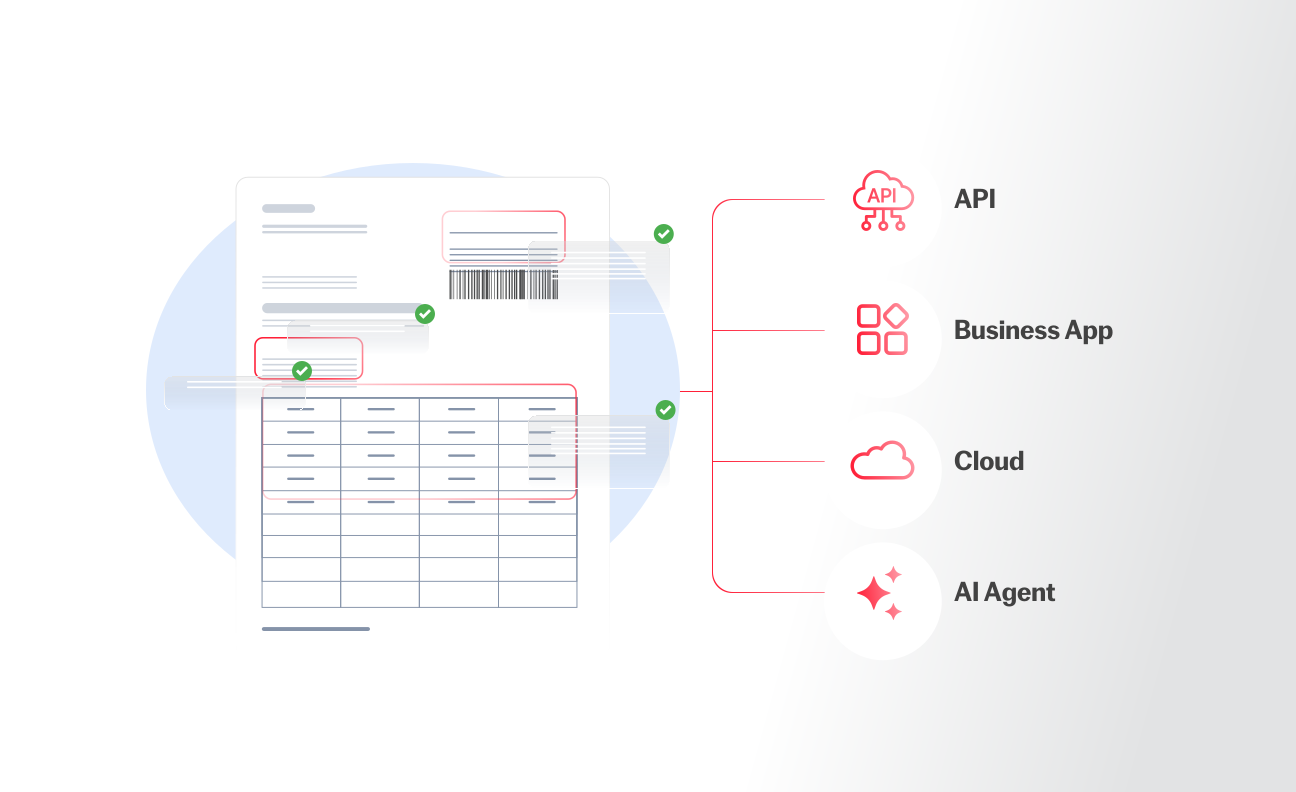
Los datos validados deben llegar a su destino, ya sea un sistema ERP con décadas de antigüedad, una plataforma desarrollada internamente, una aplicación especializada para un área de negocio concreto o un coordinador de flujos de trabajo basado en agentes. Los conectores preconfigurados cubren los sistemas empresariales más habituales con un esfuerzo de integración mínimo. Para cualquier otra cosa, una API abierta ofrece a los equipos de desarrollo la flexibilidad necesaria para crear lo que se necesite. En cualquier caso, los datos llegan en el formato que espera el sistema receptor.
La mayoría de los procesos empresariales comienzan con un documento: una factura que debe aprobarse, un contrato que da lugar a una obligación o un formulario que da inicio a un expediente. Cuando los datos estructurados se exportan directamente a los sistemas que los procesan, el documento se convierte en el evento que impulsa el proceso. Se tramitan las autorizaciones, se abren los expedientes y se realiza un seguimiento de las obligaciones, creando así un proceso integral basado en los datos que figuran en el documento.
Los datos se cifran durante la transmisión y se validan según sus reglas de negocio antes de su exportación, lo que garantiza que solo lleguen a los sistemas posteriores datos limpios y conformes, y que las discrepancias se señalen para su revisión manual. Si es necesario, se pueden ocultar de forma permanente determinados campos antes de la exportación, de modo que los datos subyacentes no se puedan recuperar del archivo exportado. Los registros de auditoría se mantienen intactos y se cumplen las obligaciones normativas, como el RGPD, la CCPA y los requisitos específicos del sector, sin necesidad de una supervisión manual.
Para los equipos de producto y desarrollo, las funciones de salida de ABBYY pueden integrarse de forma nativa en su propia aplicación, de modo que los datos estructurados lleguen a los usuarios finales como parte de la experiencia de su producto, y no como un sistema conectado al mismo.
La exportación de datos es el paso final del proceso de ABBYY IDP. Una vez que los documentos se hayan procesado, clasificado y validado, los datos estructurados estarán listos para salir del sistema y ponerse en marcha.
Es aquí donde la extracción aporta su valor empresarial. Los datos validados se formatean automáticamente según el destino al que se dirigen y se exportan a los sistemas, flujos de trabajo y procesos de inteligencia artificial que los procesan, completando así el recorrido desde el documento hasta la decisión.
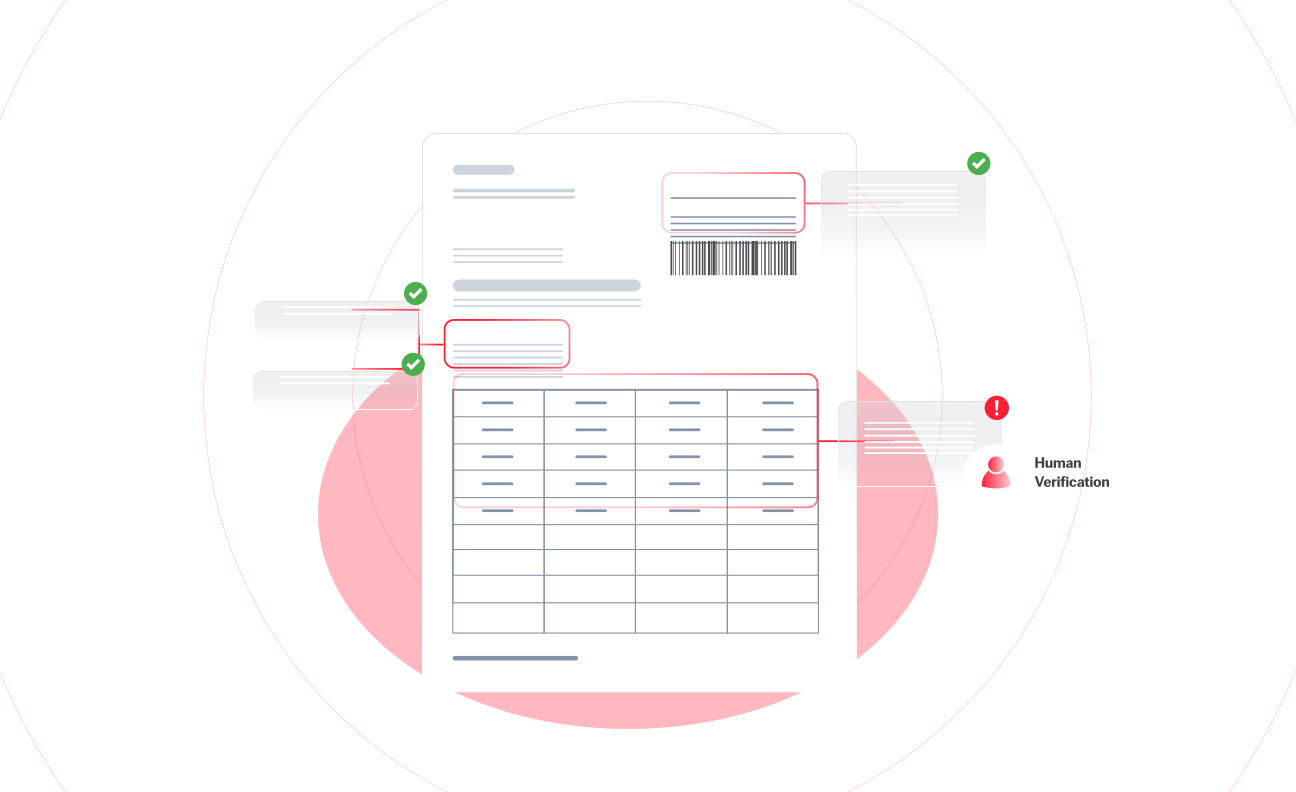
Una IA diseñada específicamente para este fin extrae datos de cualquier tipo de documento y los valida según sus reglas de negocio. Las discrepancias se señalan; los datos válidos pasan automáticamente a la siguiente fase.
Los datos validados se estructuran en el formato de salida que necesite —JSON, CSV, DocLang u otros— y quedan listos para el sistema o flujo de trabajo específico que los vaya a recibir.
Los datos se exportan de forma segura al destino que elija —API REST, carpeta compartida SFTP, base de datos ODBC, SharePoint o un sistema externo a través de un conector de Marketplace o un script personalizado— y se inicia el siguiente paso sin intervención humana.
Cómo la combinación de la IA para documentos, diseñada específicamente para este fin, con los modelos de lenguaje grande (LLM) permite crear flujos de trabajo integrales que son a la vez precisos y ricos en contexto.

Por qué unos datos de documentos limpios y estructurados son un requisito imprescindible para que los agentes de IA sean fiables, y cómo la mejora continua hace que el sistema sea cada vez más inteligente.
¿Qué ocurre cuando IDP no se limita a extraer datos, sino que dota a los agentes autónomos de la capacidad de decidir qué hacer con ellos, de forma automática, a lo largo de flujos de trabajo de principio a fin?
Las exportaciones se dividen en cuatro categorías.
DocLang es un formato de documento abierto y nativo para la inteligencia artificial, desarrollado por un grupo de trabajo del sector en el que participan ABBYY, IBM, Nvidia y Red Hat. A diferencia de los archivos PDF o HTML, define explícitamente la estructura, el diseño y el significado semántico del documento en un formato legible por máquina, lo que lo convierte en el formato de salida preferido cuando los datos de los documentos se utilizan para alimentar modelos de lenguaje grande (LLM) o flujos de trabajo de IA. Reduce las alucinaciones al basar las entradas del modelo en contenido verificado e incorpora metadatos de gobernanza, como indicadores de datos personales (PII) y políticas de uso del modelo, directamente en el archivo.
Los datos se cifran durante la transmisión y se comprueban según sus reglas de negocio antes de salir de la plataforma. Se pueden ocultar de forma permanente determinados campos antes de la exportación, de modo que aparezcan como zonas tachadas en las imágenes exportadas y los datos subyacentes resulten irrecuperables. Esto garantiza el cumplimiento del RGPD, la CCPA y los requisitos específicos del sector sin necesidad de supervisión manual en el momento de la exportación.
Sí. Los flujos de trabajo de exportación pueden configurarse para iniciar acciones posteriores —rutas de aprobación, generación de informes, señalización de incumplimientos— en función del contenido y el estado de los datos exportados, ampliando así la automatización desde el procesamiento de documentos hasta los procesos empresariales que dependen de él.
Los datos se validan según sus reglas de negocio antes de la exportación. Si se detecta alguna discrepancia —un campo sin rellenar, un valor fuera de rango o una infracción de las normas—, el documento se marca para su revisión manual en lugar de pasar a la siguiente fase del proceso, lo que garantiza la integridad de los datos en todos sus flujos de trabajo.
Programe una demostración y vea cómo la automatización inteligente de ABBYY puede cambiar su forma de trabajar, para siempre.
Cómo la combinación de la IA para documentos, diseñada específicamente para este fin, con los modelos de lenguaje grande (LLM) permite crear flujos de trabajo integrales que son a la vez precisos y ricos en contexto.

Por qué unos datos de documentos limpios y estructurados son un requisito imprescindible para que los agentes de IA sean fiables, y cómo la mejora continua hace que el sistema sea cada vez más inteligente.
¿Qué ocurre cuando IDP no se limita a extraer datos, sino que dota a los agentes autónomos de la capacidad de decidir qué hacer con ellos, de forma automática, a lo largo de flujos de trabajo de principio a fin?