Los documentos que utilice para evaluar el analizador deben provenir de los tipos de documentos que su organización usa habitualmente en el día a día. Su conjunto de prueba debe incluir como mínimo:
- Documentos escaneados: imágenes de papel con calidad de escaneo variable, inclinación y ruido. Aquí es donde la calidad del reconocimiento óptico de caracteres (Optical Character Recognition, OCR) diferencia a los analizadores de nivel comercial de las herramientas de código abierto como Tesseract.
- Diseños de múltiples columnas: informes financieros, artículos académicos y boletines que presentan texto en columnas paralelas. Los analizadores que no pueden detectar los límites de columna mezclarán contenido de columnas adyacentes, produciendo fragmentos factualmente incoherentes.
- Tablas complejas: tablas sin bordes, celdas combinadas y tablas que abarcan varias páginas. La salida de tablas aplanadas es uno de los modos de fallo silencioso más comunes en producción.
- Contenido multilingüe: documentos que mezclan idiomas o utilizan escrituras no latinas, como árabe, chino, japonés y coreano. La cobertura varía significativamente entre analizadores. ABBYY admite 208 idiomas, mientras que muchas herramientas de código abierto quedan muy por debajo de esa cifra.
- Documentos largos de varias páginas: contratos, manuales técnicos e informes en los que las jerarquías de secciones abarcan docenas o cientos de páginas. El orden de lectura y la continuidad estructural entre saltos de página son puntos de fallo frecuentes.
- Estructura inconsistente: los documentos reales no son uniformes. Los encabezados aparecen en lugares inesperados. Las notas al pie interrumpen el cuerpo del texto. Los documentos que a primera vista parecen estructurados son con frecuencia irregulares de maneras que confunden a los analizadores entrenados con formatos limpios.
Evalúe cómo gestiona el analizador la ambigüedad estructural, no solo los documentos con un formato claro y coherente. Sin un conjunto de prueba realista de estos tipos de documentos, su evaluación está midiendo condiciones de demo, no realidades de producción.
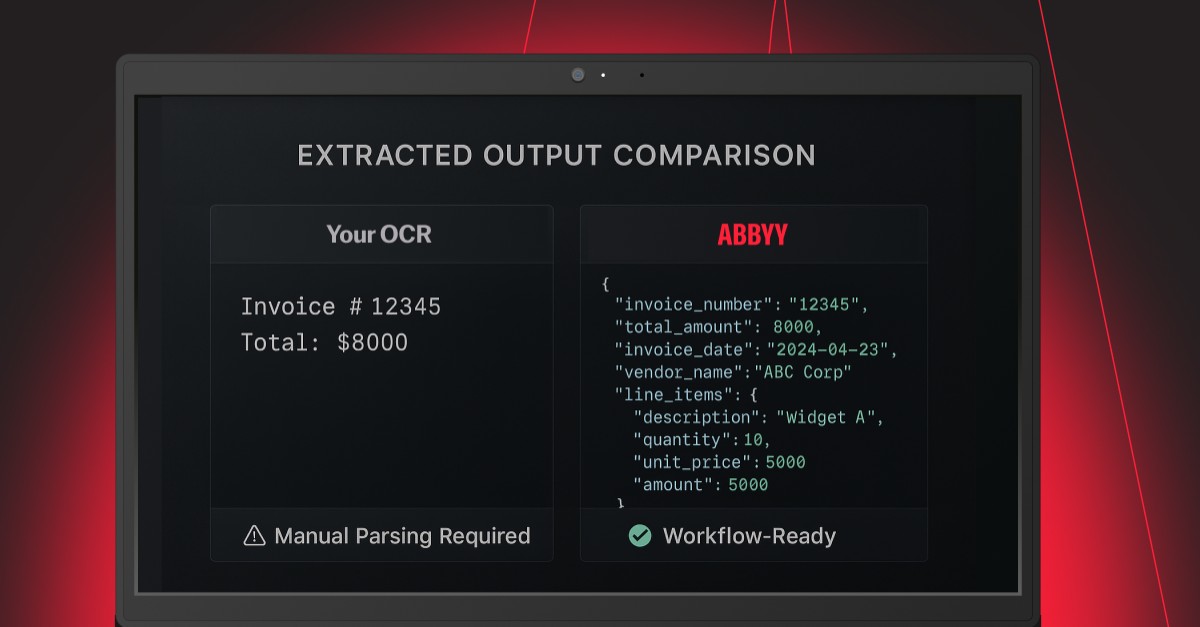
La precisión a nivel de caracteres, es decir, el porcentaje de caracteres extraídos correctamente, le dice muy poco sobre si un analizador admitirá una recuperación RAG fiable. Un analizador puede lograr una alta precisión de caracteres mientras destruye por completo la estructura de información que su sistema posterior necesita.
Evalúe cada uno de los siguientes aspectos:
- Preservación de la estructura: ¿se identifican y etiquetan correctamente los encabezados, las secciones y la jerarquía del documento? La fragmentación que sigue la estructura real del documento produce una recuperación mejor que la fragmentación que adivina los límites.
- Orden de lectura: ¿está el texto extraído en el orden que seguiría un lector humano? Los documentos de varias columnas y los diseños complejos con frecuencia hacen que los analizadores produzcan texto en la secuencia incorrecta.
- Fidelidad de tablas: ¿se preservan en la salida las relaciones entre filas y columnas? Una tabla que se aplana en una cadena de texto pierde las relaciones que la hacen significativa para un modelo posterior.
- Relaciones entre campos y etiquetas: en formularios y documentos estructurados, ¿asocia el analizador correctamente los valores de los campos con sus etiquetas? Los valores disociados son una fuente habitual de errores fácticos en las salidas RAG.
- Utilidad del formato de salida: ¿lleva el formato de salida suficiente información semántica para que la fragmentación y la recuperación funcionen correctamente? El texto plano elimina el contexto que hace precisa la recuperación.
Un formato estructurado como DocLang, co-creado por ABBYY junto con IBM, Nvidia, Red Hat y la Linux Foundation como un estándar abierto de marcado de documentos nativo para IA, incluye etiquetas semánticas para encabezados, párrafos, celdas de tabla, notas al pie y campos de formulario. Esa estructura es lo que hace que la salida sea genuinamente apta para la IA.
El rendimiento en laboratorio es lo que un analizador obtiene en un benchmark controlado. El rendimiento operacional es lo que hace con sus documentos, a su volumen y bajo sus restricciones.
Los analizadores más eficaces son los que producen una estructura de datos eficiente y predecible en distintos tipos de documentos. Esa evaluación debe ir más allá de la precisión OCR simple para medir la comprensión semántica.
Existe una categoría de resultado de evaluación que genera problemas reales: "suficientemente bueno en la mayoría de los documentos."
La pregunta no es si su analizador gestiona bien los documentos limpios, sino si puede procesar su corpus de forma fiable sin introducir errores que se propaguen hacia las etapas posteriores del canal.
"Suficientemente bueno" pasa por alto el efecto acumulativo de los errores parciales. Un analizador que extrae correctamente el 98% del contenido de un documento pero aplana sistemáticamente todas las tablas puede producir una salida utilizable para la mayoría de las consultas, pero falla por completo en cualquier consulta que requiera datos de tablas. La cifra de precisión agregada del 98% no refleja la tasa de fallo del 100% en consultas que dependen de tablas.
Si esos errores involucran términos financieros clave, fechas o cláusulas de responsabilidad, las consecuencias en etapas posteriores no son abstractas.
Por eso, evaluar específicamente los tipos de documentos y las características estructurales que más importan para su caso de uso es fundamental. Si su canal depende de la extracción de tablas, evalúe específicamente la fidelidad de las tablas. Si procesa documentos multilingües, evalúe la precisión por idioma. Si depende de la jerarquía de secciones para la fragmentación, evalúe si los límites de sección se identifican correctamente.
Los documentos difíciles revelan el techo real del rendimiento.
Una comparación directa le ofrece la señal más útil para actuar. Ejecute el mismo conjunto de documentos a través de su analizador actual y del analizador que está evaluando; luego compare los resultados en paralelo en las dimensiones que importan para su canal.
Concretamente:
- Paso 1: seleccione un conjunto de benchmark de 50 a 100 documentos. Priorice los documentos complejos y desafiantes de su corpus real, no los más sencillos.
- Paso 2: analice cada documento con ambas herramientas. Guarde la salida completa para una evaluación posterior.
- Paso 3: seleccione una muestra de 10 a 20 documentos para inspeccionar manualmente la estructura, el orden de lectura y la fidelidad de las tablas. Evite depender únicamente de las métricas a nivel de caracteres, ya que no destacan los fallos estructurales que más afectan al rendimiento.
- Paso 4: ejecute una prueba de recuperación preparando un conjunto de preguntas con respuestas conocidas que se encuentran en sus documentos. Indexe la salida analizada de cada herramienta y evalúe si la recuperación muestra los pasajes correctos.
- Paso 5: compare los formatos de salida para determinar si el formato de su analizador actual contiene suficiente estructura semántica para que su lógica de fragmentación funcione correctamente.Si no es así, considere un formato como DocLang, con etiquetado semántico, que puede mejorar de forma medible los resultados de fragmentación y recuperación.
El objetivo no es encontrar un analizador que puntúe más alto en una tabla de clasificación. El objetivo es encontrar un analizador que produzca mejores resultados en su canal específico, con sus documentos específicos.
La forma más rápida de entender el límite de rendimiento en producción de un analizador es darle primero sus documentos más desafiantes: los que actualmente causan problemas en su canal, los que producen alucinaciones, tablas rotas o un orden de lectura ininteligible.
Con FineParser impulsado por ABBYY, puede obtener el contenedor Docker, ejecutarlo en los documentos que ya están causando problemas y comparar la salida estructurada con lo que produce su analizador actual.
La diferencia entre lo que devuelve su analizador y lo que devuelve un analizador que preserva la estructura le dirá más sobre el límite de fiabilidad de su canal que cualquier puntuación de benchmark.
Pruebe ABBYY con sus documentos reales; el acceso anticipado ya está disponible.

