Optimisez l'automatisation de l'IA grâce à la puissance d'une OCR fiable et précise
Améliorer le traitement direct des documents grâce à des informations fondées sur des données
Automatisez grâce à une IA documentaire fiable et facile à intégrer
COMPRÉHENSION DES PROCESSUS
OPTIMISATION DES PROCESSUS
L’IA conçue sur mesure pour une automatisation sans limite.
Lancez votre automatisation grâce aux modèles IA d’extraction préconfigurés.
Rencontrez les contributeurs, explorer les ressources et plus encore.
Par secteur
Par processus d'entreprise
Par technologie
CONSTRUIRE
Intégrez la reconnaissance de texte avancée dans vos applications via une API.
Infrastructure d’analyse documentaire pour les workflows d’IA.
Données documentaires prêtes pour l'IA pour une sortie GenAI contextualisée grâce à la RAG.
CROÎTRE
Échangez avec des personnes partageant les mêmes idées et avec des experts expérimentés en OCR, IDP et IA.
Ce titre prestigieux est décerné aux développeurs qui font preuve d'une expertise exceptionnelle dans le domaine de l'ABBYY AI.
Explorez
Connaissances
Services
Export de données

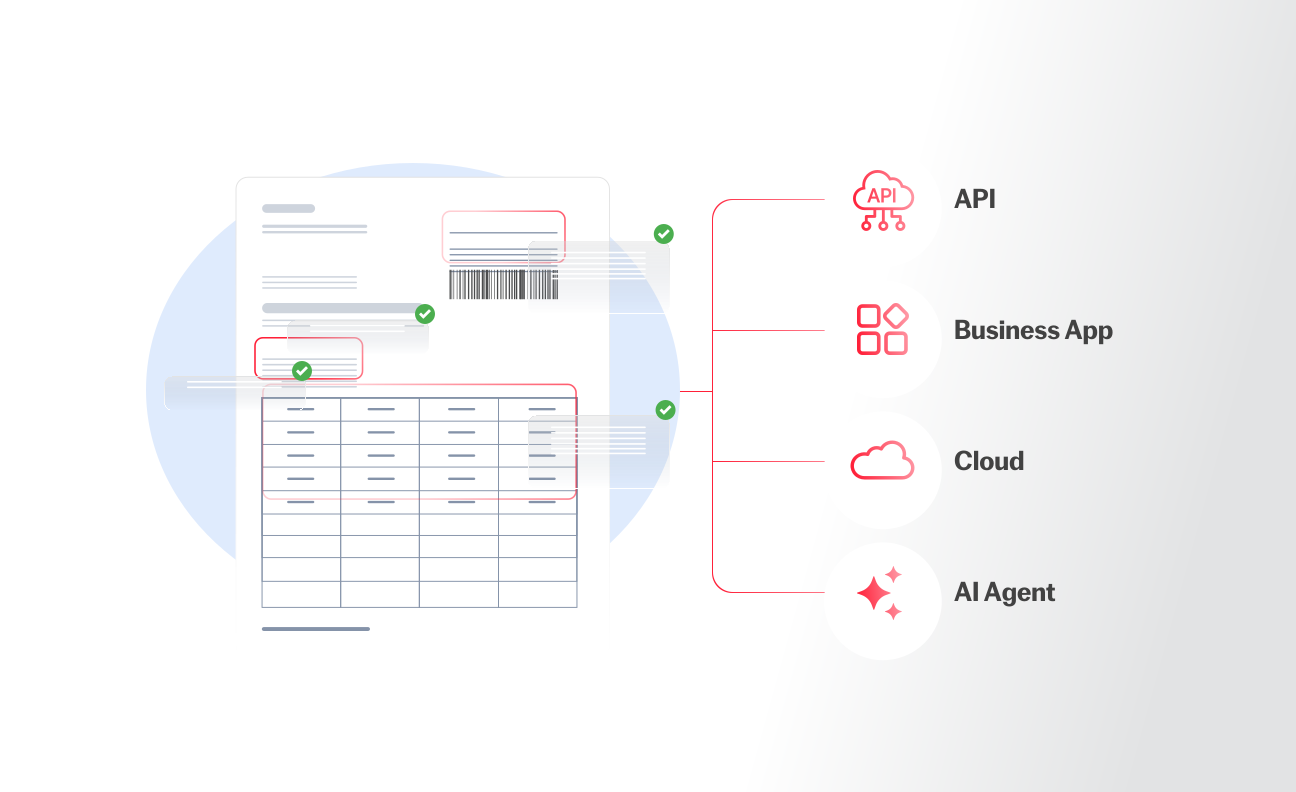
Les données extraites de vos documents et validées doivent parvenir aux systèmes dont dépendent vos processus (ERP, CRM, plateformes d'automatisation, workflows agentiques ou modèles d'IA), idéalement sans intervention manuelle. L’IA documentaire ABBYY assure cette dernière étape en exportant automatiquement les données au format requis par chaque système en aval et en les acheminant via l'API REST ou des connecteurs prédéfinis disponibles sur l'ABBYY Marketplace.
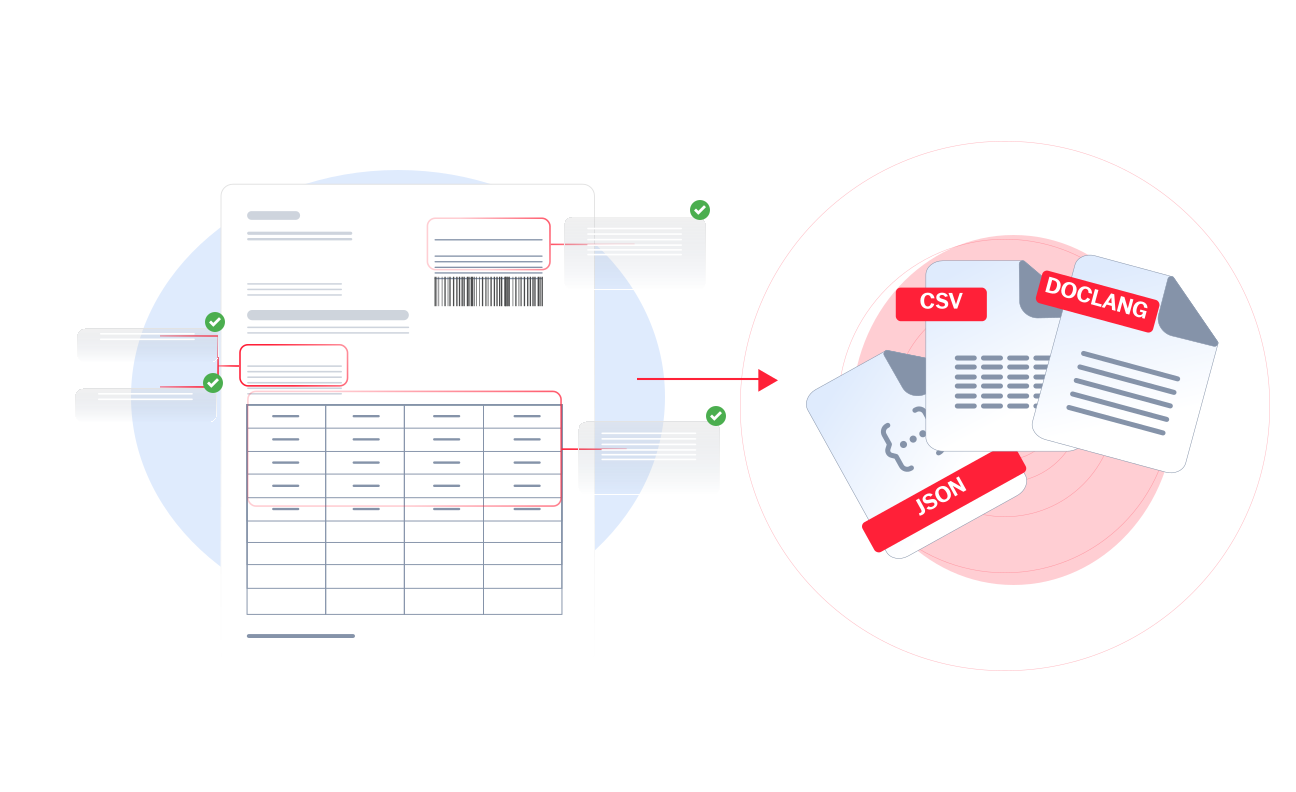
Les champs de données, structurés, sont exportés aux formats JSON ou CSV, nettoyés, validés et immédiatement utilisables dans les ERP, les bases de données ou les workflows (flux de travail) agentiques.
Doclang fournit une représentation lisible par machine du document complet, incluant la structure, la mise en page et les métadonnées de gouvernance. Ainsi, les grands modèles de langage (LLM) et les agents d'IA travaillent à partir de données vérifiées, et non d'approximations.
Les textes reconnus sont exportés aux formats DOCX, XLSX, HTML et autres formats modifiables, en préservant la structure originale du document.
Les images traitées sont exportées sous forme de fichiers PDF et PDF/A interrogeables, pour faciliter leur récupération et leur archivage à long terme. Elles sont aussi envoyées directement sur SharePoint ou sur un stockage partagé. Les champs sensibles peuvent être définitivement retirés avant l'exportation lorsque la conformité l'exige.

Les données validées doivent atteindre leur destination, qu'il s'agisse d'un ERP vieux de plusieurs décennies, d'une plateforme développée en interne, d'une application métier spécialisée ou d'un orchestrateur de flux de travail agentiques. Les connecteurs prédéfinis couvrent les systèmes d'entreprise les plus courants avec un effort d'intégration minimal. Pour tout le reste, une API ouverte donne aux équipes de développement la flexibilité nécessaire pour créer ce dont elles ont besoin. Dans les deux cas de figure, les données arrivent dans le format attendu par le système de réception.
La plupart des processus métier commencent par un document : une facture à approuver, un contrat donnant lieu à une obligation, un formulaire ouvrant un dossier. Lorsque les données structurées sont directement exportées vers les systèmes qui les traitent, le document devient l’élément déclencheur du processus. Les approbations sont acheminées, les dossiers ouverts et les obligations suivies, ce qui crée un processus de bout en bout alimenté par les données du document.
Les données sont cryptées lors du transfert et validées selon vos règles métier avant exportation, ce qui garantit que seules des données propres et conformes parviennent aux systèmes en aval. Les anomalies sont signalées pour vérification humaine. Si nécessaire, certains champs peuvent être définitivement retirés avant l’exportation et les données sous-jacentes peuvent être rendues irrécupérables dans le fichier exporté. Les pistes d’audit sont préservées et les obligations réglementaires, telles que le RGPD, le CCPA et les exigences propres à chaque secteur d’activité, sont respectées sans contrôle manuel.
Pour les équipes produit et développement, les fonctionnalités d'exportation d'ABBYY peuvent être nativement intégrées à votre application. Ainsi, les données structurées parviennent aux utilisateurs finaux directement dans le cadre de l'expérience utilisateur de votre produit, et non via un système externe.
L'exportation des données est l'étape finale du pipeline ABBYY de traitement intelligent des documents (IDP). Une fois vos documents traités, classés et validés, les données structurées sont prêtes à quitter le système et à être exploitées.
C'est là que l'extraction révèle toute sa valeur pour votre activité. Les données validées sont automatiquement formatées pour leur destination et exportées vers les systèmes, les flux de travail et les pipelines d'IA qui les utilisent, bouclant ainsi le processus allant du document à la prise de décision.
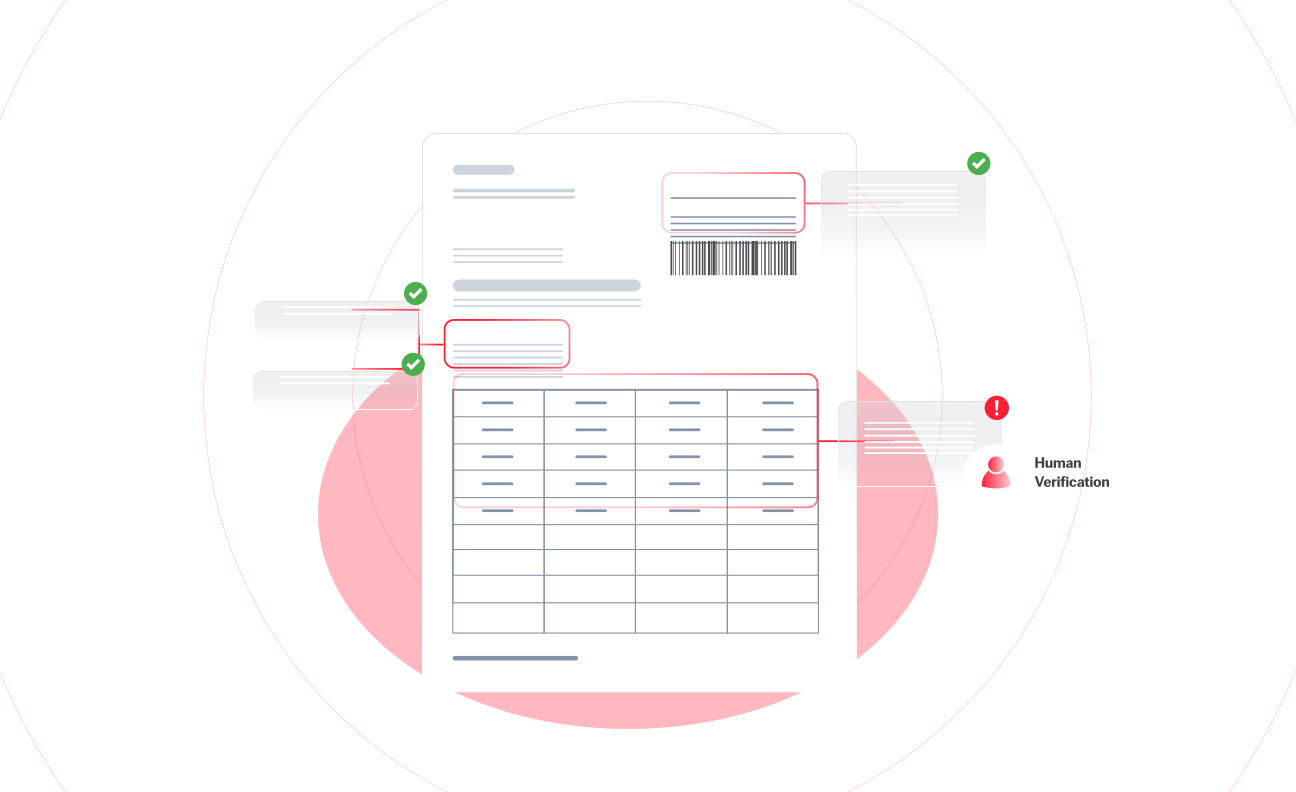
Une IA sur mesure extrait les données de tout type de document et les valide selon vos règles métier. Les anomalies sont signalées ; les données ainsi nettoyées sont automatiquement acheminées.
Les données validées sont structurées dans le format de sortie requis (JSON, CSV, Doclang, ou autres) et prêtes pour le système ou le flux de travail spécifique qui va les recevoir.
Les données sont exportées en toute sécurité vers la destination de votre choix (API REST, dossier partagé SFTP, base de données ODBC, SharePoint ou système externe via un connecteur Marketplace ou un script personnalisé), ce qui déclenche automatiquement l'étape suivante.
Comment l’association d’une IA documentaire dédiée et des LLM crée-t-elle des flux de travail de bout en bout à la fois précis et riches en contexte.

Pourquoi des données documentaires propres et structurées sont-elles un prérequis pour des agents d’IA fiables, et comment l’amélioration continue permet-elle au système de devenir plus intelligent.
Que se passe-t-il lorsque l’IDP ne se contente pas d’extraire des données, mais dote des agents autonomes de la capacité de décider automatiquement quoi en faire, tout au long des flux de travail ?
Pourquoi des données documentaires propres et structurées sont-elles un prérequis pour des agents d’IA fiables, et comment l’amélioration continue permet-elle au système de devenir plus intelligent.
Les exportations se répartissent en quatre catégories.
Doclang est un format de document ouvert, natif de l'IA, développé par un groupe de travail industriel comprenant ABBYY, IBM, Nvidia et Red Hat. Contrairement aux formats PDF ou HTML, il définit explicitement la structure, la mise en page et le sens sémantique du document sous une forme lisible par les machines, ce qui en fait le format de sortie privilégié lorsque les données documentaires alimentent des grands modèles de langage (LLM) ou des pipelines d'IA. Il réduit les hallucinations en ancrant les entrées du modèle dans un contenu vérifié et intègre des métadonnées de gouvernance, telles que les indicateurs de données personnelles et les politiques d'utilisation du modèle, directement dans le fichier.
Les données sont cryptées pendant leur transmission et validées selon vos règles métier avant de quitter la plateforme. Certains champs peuvent être définitivement retirés avant l'exportation, apparaissant comme des zones caviardées dans les images exportées, les données sous-jacentes étant irrécupérables. Ceci garantit la conformité au RGPD, au CCPA et aux exigences sectorielles sans intervention manuelle lors de l'exportation.
Oui. Les flux d'exportation peuvent être configurés de façon à initier des actions en aval (parcours d'approbation, génération de rapports, signalement de conformité) en fonction du contenu et du statut des données exportées, étendant ainsi l'automatisation du traitement documentaire aux processus métier qui en dépendent.
Les données sont validées selon vos règles métier avant l'exportation. Si une anomalie est détectée (champ manquant, valeur hors des clous ou violation de règle), le document est signalé pour vérification humaine au lieu d'être transmis en aval. Cela protège l'intégrité des données dans vos flux de travail.
Programmez une démonstration et voyez comment l’automatisation intelligente d’ABBYY peut changer la façon dont vous travaillez – pour toujours
Comment l’association d’une IA documentaire dédiée et des LLM crée-t-elle des flux de travail de bout en bout à la fois précis et riches en contexte.

Que se passe-t-il lorsque l’IDP ne se contente pas d’extraire des données, mais dote des agents autonomes de la capacité de décider automatiquement quoi en faire, tout au long des flux de travail ?