Les documents utilisés pour évaluer un analyseur doivent être représentatifs des types de documents que votre organisation traite au quotidien. Votre jeu de test doit inclure au minimum :
- Documents numérisés : images de documents papier présentant différents niveaux de qualité de numérisation, ainsi que des problèmes d’inclinaison et de bruit. C’est notamment sur ce type de documents que la qualité de la reconnaissance optique de caractères (Optical Character Recognition, OCR) permet de distinguer les analyseurs professionnels des outils open source comme Tesseract.
- Mises en page à plusieurs colonnes : rapports financiers, publications universitaires et lettres d’information présentant du texte sur plusieurs colonnes parallèles. Les analyseurs incapables de détecter les limites entre les colonnes risquent d’entremêler le contenu de colonnes adjacentes et de produire ainsi des segments dont le contenu manque de cohérence.
- Tableaux complexes : tableaux sans bordures, cellules fusionnées et tableaux s’étendant sur plusieurs pages. La restitution des tableaux sous une forme aplatie constitue l’un des dysfonctionnements silencieux les plus fréquents en production.
- Contenu multilingue : documents mêlant plusieurs langues ou utilisant des systèmes d’écriture non latins, comme l’arabe, le chinois, le japonais ou le coréen. La couverture linguistique varie considérablement d’un analyseur à l’autre. ABBYY prend en charge 208 langues, tandis que de nombreux outils open source sont loin d’offrir une couverture comparable.
- Documents longs de plusieurs pages : contrats, manuels techniques et rapports dont la hiérarchie des sections s’étend sur des dizaines, voire des centaines de pages. L’ordre de lecture et la continuité de la structure d’une page à l’autre constituent des sources fréquentes d’erreurs.
- Structure incohérente : les documents réels sont rarement parfaitement uniformes. Les en-têtes peuvent apparaître à des endroits inattendus. Les notes de bas de page peuvent interrompre le corps du texte. Même des documents qui semblent bien structurés à première vue présentent souvent des irrégularités susceptibles de mettre en difficulté les analyseurs entraînés sur des formats parfaitement structurés.
Évaluez la manière dont l'analyseur gère l'ambiguïté structurelle, et pas seulement les documents avec une mise en forme claire et uniforme. Sans un jeu de test réaliste incluant ces types de documents, votre évaluation mesure des conditions de démo, et non les réalités de la production.
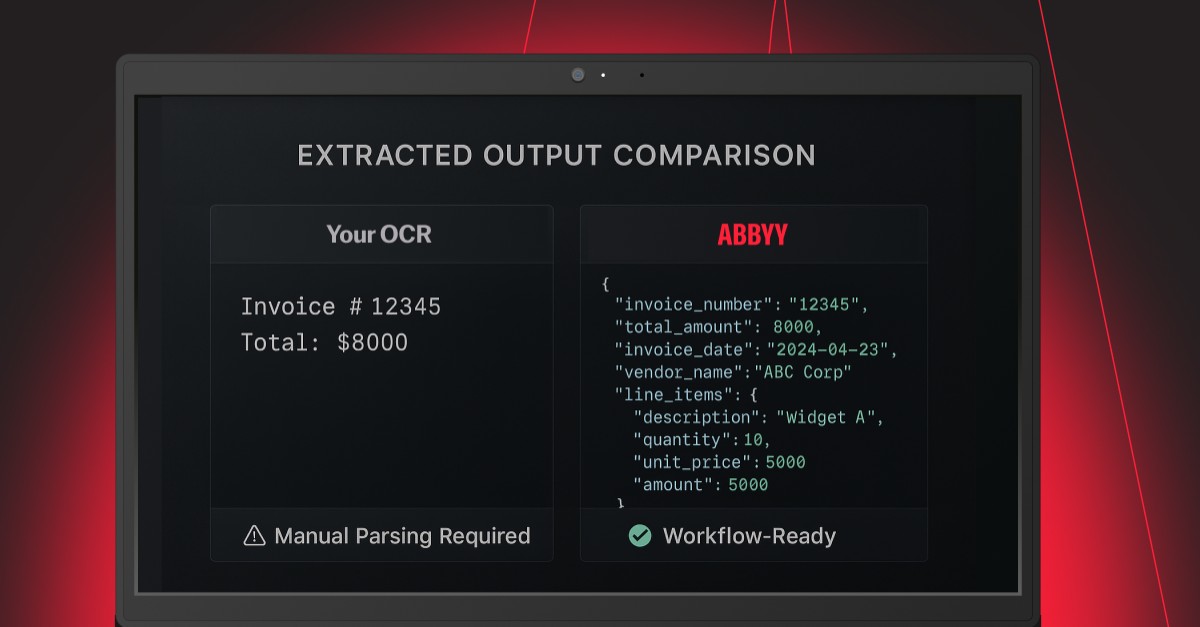
C La précision au niveau des caractères, c’est-à-dire le pourcentage de caractères correctement extraits, renseigne très peu sur la capacité d’un analyseur à assurer une recherche d’information fiable dans le cadre d’un système RAG. Un analyseur peut afficher une excellente précision au niveau des caractères tout en détruisant complètement la structure de l’information dont les systèmes en aval ont besoin.
Testez chacun des points suivants :
- Préservation de la structure : les titres, les sections et la hiérarchie du document sont-ils correctement identifiés et balisés ? Une segmentation fondée sur la structure réelle du document permet une recherche d’information plus pertinente qu’une segmentation qui détermine approximativement les limites des différents blocs de contenu.
- Ordre de lecture : le texte extrait respecte-t-il l’ordre dans lequel un lecteur humain parcourrait le document ? Les documents à plusieurs colonnes et les mises en page complexes conduisent fréquemment les analyseurs à restituer le texte dans le mauvais ordre.
- Fidélité des tableaux : les relations entre lignes et colonnes sont-elles préservées dans le résultat obtenu ? Lorsqu’un tableau est aplati en une simple chaîne de texte, les relations qui lui donnent son sens sont perdues, ce qui le rend difficilement exploitable par les modèles utilisés en aval.
- Relations entre champs et libellés : dans les formulaires et les documents structurés, l'analyseur associe-t-il correctement les valeurs de champs à leurs libellés ? Les valeurs dissociées constituent une source fréquente d'erreurs factuelles dans les réponses générées par les systèmes RAG.
- Utilité du format de sortie : le format de sortie conserve-t-il suffisamment d’informations sémantiques pour permettre une segmentation et une recherche d’information efficaces ? Le texte brut élimine une partie du contexte indispensable à la pertinence de la recherche.
Un format structuré comme DocLang, développé conjointement par ABBYY, IBM, Nvidia, Red Hat et la Linux Foundation comme standard ouvert de balisage documentaire natif pour l’IA, intègre des balises sémantiques pour les titres, les paragraphes, les cellules de tableaux, les notes de bas de page et les champs de formulaires. C’est cette structure qui rend les données extraites véritablement exploitables par l’IA.
Les performances en laboratoire correspondent aux scores obtenus par un analyseur sur un benchmark soigneusement sélectionné. Les performances opérationnelles correspondent aux résultats qu’il obtient sur vos propres documents, avec vos volumes de traitement et dans vos conditions réelles d’utilisation.
Les analyseurs les plus efficaces sont ceux qui produisent une structure de données fiable et prévisible sur des types de documents variés. Cette évaluation doit aller au-delà de la simple précision OCR pour mesurer la compréhension sémantique.
Il existe un type de résultat d’évaluation particulièrement problématique : « suffisamment performant sur la plupart des documents ».
La question n'est pas de savoir si votre analyseur traite bien les documents propres, mais s'il peut traiter votre corpus de façon fiable sans introduire d'erreurs qui se propagent en aval dans le pipeline.
Une performance « suffisamment bonne » ne tient pas compte de l’effet cumulatif des erreurs partielles. Un analyseur qui extrait correctement 98 % du contenu d’un document, mais qui aplatit systématiquement tous les tableaux, peut produire des résultats exploitables pour la plupart des requêtes tout en échouant totalement dès qu’une requête nécessite des données contenues dans un tableau. Un taux de précision global de 98 % ne rend pas compte d’un taux d’échec de 100 % pour les requêtes qui dépendent de ces données.
Lorsque ces erreurs concernent des données financières essentielles, des dates ou des clauses de responsabilité, leurs conséquences sur les traitements en aval sont bien réelles.
C’est pourquoi il est essentiel d’évaluer en priorité les types de documents et les caractéristiques structurelles qui comptent le plus pour votre cas d’usage. Si votre pipeline repose sur l’extraction de tableaux, évaluez spécifiquement la fidélité de leur restitution. Si vous traitez des documents multilingues, mesurez la précision pour chaque langue. Si votre segmentation repose sur la hiérarchie des sections, vérifiez que les limites entre les sections sont correctement identifiées.
Les documents difficiles révèlent les limites de performance.
Une comparaison directe vous fournit le signal le plus exploitable. Faites traiter le même jeu de documents par votre analyseur actuel et par celui que vous évaluez, puis comparez les résultats côte à côte selon les critères qui comptent pour votre pipeline.
Plus précisément :
- Étape 1 : sélectionnez un jeu de référence de 50 à 100 documents. Privilégiez les documents complexes et difficiles de votre corpus réel, et non les plus simples.
- Étape 2 : analysez chaque document avec les deux outils. Conservez l’intégralité des résultats obtenus pour une évaluation approfondie.
- Étape 3 : sélectionnez un échantillon de 10 à 20 documents pour inspecter manuellement la structure, l'ordre de lecture et la fidélité des tableaux. Ne vous fiez pas uniquement aux métriques de précision au niveau des caractères : elles ne permettent pas de détecter les erreurs structurelles qui ont le plus d’impact sur les performances.
- Étape 4 : effectuez un test de recherche d’information en préparant une série de questions dont les réponses sont connues et figurent dans vos documents. Indexez les résultats obtenus par chaque outil, puis vérifiez si la recherche permet de retrouverles passages corrects.
- Étape 5 : comparez les formats de sortie pour déterminer si le format de votre analyseur actuel contient suffisamment de structure sémantique pour que votre logique de segmentation fonctionne correctement. Si ce n'est pas le cas, envisagez un format comme DocLang, avec un balisage sémantique, qui peut améliorer de manière mesurable la qualité de la segmentation et de la recherche d’information.
L’objectif n’est pas de trouver l’analyseur qui obtient le meilleur score dans un classement. Il s’agit de déterminer lequel offre les meilleurs résultats dans votre propre pipeline, avec vos propres documents.
Le moyen le plus rapide de cerner les limites d’un analyseur en production consiste à lui soumettre d’abord vos documents les plus difficiles : ceux qui posent déjà problème dans votre pipeline, qui entraînent des hallucinations, des tableaux mal restitués ou un ordre de lecture incohérent.
Avec FineParser d'ABBYY, vous pouvez récupérer le conteneur Docker, l’exécuter sur les documents qui posent déjà problème et comparer les résultats structurés obtenus avec ceux de votre analyseur actuel.
La différence entre ce que retourne votre analyseur et ce que retourne un analyseur préservant la structure vous en dira plus sur les limites de fiabilité de votre pipeline que n'importe quel score obtenu sur un benchmark.
Testez ABBYY sur vos documents réels. L'accès anticipé est désormais ouvert.

