Die Dokumente, die Sie zur Evaluierung eines Parsers verwenden, sollten aus den Dokumenttypen stammen, die in Ihrer Organisation täglich eingesetzt werden. Ihr Testset sollte mindestens Folgendes umfassen:
- Gescannte Dokumente: Papierbilder mit variierender Scanqualität, Verzerrungen und Rauschen. Hier trennt die Qualität der optischen Zeichenerkennung (Optical Character Recognition – OCR) kommerzielle Parser von Open-Source-Tools wie Tesseract.
- Mehrspaltenlayouts: Finanzberichte, wissenschaftliche Publikationen und Newsletter, die Text in parallelen Spalten darstellen. Parser, die Spaltengrenzen nicht erkennen, vermischen Inhalte benachbarter Spalten und erzeugen sachlich inkohärente Chunks.
- Komplexe Tabellen: Randlose Tabellen, zusammengeführte Zellen und Tabellen, die sich über mehrere Seiten erstrecken. Die Ausgabe von abgeflachten Tabellen ist einer der häufigsten stillen Fehler im Produktivbetrieb.
- Mehrsprachige Inhalte: Dokumente, die Sprachen mischen oder nicht-lateinische Schriften verwenden, etwa Arabisch, Chinesisch, Japanisch und Koreanisch. Die Sprachabdeckung variiert erheblich zwischen verschiedenen Parsern. ABBYY unterstützt 208 Sprachen, während viele Open-Source-Tools deutlich dahinter zurückbleiben.
- Lange, mehrseitige Dokumente: Verträge, technische Handbücher und Berichte, bei denen Abschnittshierarchien sich über Dutzende oder Hunderte von Seiten erstrecken. Lesereihenfolge und strukturelle Kontinuität über Seitenumbrüche hinweg sind häufige Schwachstellen.
- Inkonsistente Struktur: Reale Dokumente sind nicht konsistent. Überschriften erscheinen an unerwarteten Stellen. Fußnoten unterbrechen den Fließtext. Dokumente, die auf den ersten Blick strukturiert wirken, weisen häufig Unregelmäßigkeiten auf, die Parser überfordern, die auf bereinigten Formaten trainiert wurden.
Bewerten Sie, wie der Parser mit strukturellen Mehrdeutigkeiten umgeht – nicht nur mit klar und konsistent formatierten Dokumenten. Ohne einen realistischen Testset dieser Dokumenttypen messen Sie Demo-Bedingungen, keine Produktionsrealitäten.
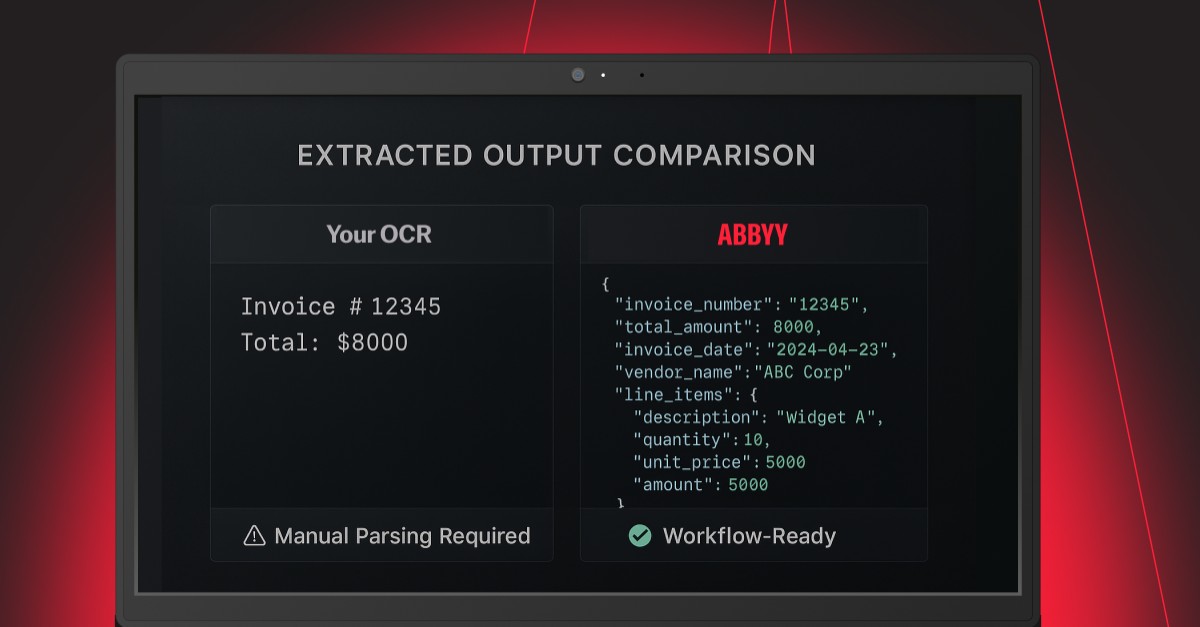
Die Genauigkeit auf Zeichenebene – also der Prozentsatz korrekt extrahierter Zeichen – sagt wenig darüber aus, ob ein Parser ein zuverlässiges RAG-Retrieval unterstützt. Ein Parser kann eine hohe Zeichengenauigkeit erzielen und dabei gleichzeitig die Informationsstruktur, die Ihr nachgelagertes System benötigt, vollständig zerstören.
Testen Sie jeweils Folgendes:
- Strukturerhalt: Werden Überschriften, Abschnitte und Dokumenthierarchien korrekt identifiziert und gekennzeichnet? Chunking, das der tatsächlichen Dokumentstruktur folgt, liefert bessere Retrieval-Ergebnisse als Chunking, das Grenzen nur schätzt.
- Lesereihenfolge: Liegt der extrahierte Text in der Reihenfolge vor, die ein menschlicher Leser verfolgen würde? Mehrspaltige Dokumente und komplexe Layouts führen häufig dazu, dass Parser Text in falscher Reihenfolge ausgeben.
- Tabellentreue: Werden Zeilen- und Spaltenbeziehungen in der Ausgabe erhalten? Eine Tabelle, die zu einer Zeichenkette abgeflacht wird, verliert die Beziehungen, die sie für ein nachgelagertes Modell bedeutsam machen.
- Feld- und Beschriftungsbeziehungen: Ordnet der Parser in Formularen und strukturierten Dokumenten Feldwerte korrekt ihren Beschriftungen zu? Falsch zugeordnete Werte sind eine häufige Quelle von sachlichen Fehlern in RAG-Ausgaben.
- Nützlichkeit des Ausgabeformats: Enthält das Ausgabeformat genügend semantische Informationen, damit Chunking und Retrieval korrekt funktionieren? Einfacher Text entfernt den Kontext, der Retrieval präzise macht.
Ein strukturiertes Format wie DocLang – das von ABBYY gemeinsam mit IBM, Nvidia, Red Hat und der Linux Foundation als offener, KI-nativer Dokumenten-Markup-Standard entwickelt wurde – enthält semantische Labels für Überschriften, Absätze, Tabellenzellen, Fußnoten und Formularfelder. Diese Struktur macht die Ausgabe wirklich KI-bereit.
Die Laborleistung ist das, was ein Parser auf einem kuratierten Benchmark erzielt. Die operative Leistung ist das, was er mit Ihren Dokumenten, in Ihrem Volumen und unter Ihren Rahmenbedingungen leistet.
Die wirksamsten Parser sind jene, die über verschiedene Dokumenttypen hinweg eine effiziente, vorhersehbare Datenstruktur liefern. Eine entsprechende Evaluierung muss über die reine OCR-Genauigkeit hinausgehen und das semantische Verständnis messen.
Es gibt eine Kategorie von Evaluierungsergebnissen, die echte Probleme verursacht: „gut genug für die meisten Dokumente."
Die entscheidende Frage ist nicht, ob Ihr Parser mit bereinigten Dokumenten gut umgeht. Die Frage ist, ob er Ihren Corpus zuverlässig verarbeiten kann, ohne Fehler einzuführen, die sich durch die nachgelagerte Pipeline fortpflanzen.
„Gut genug" übersieht den kumulativen Effekt partieller Fehler. Ein Parser, der 98 % des Dokumenteninhalts korrekt extrahiert, aber konsequent alle Tabellen abflacht, kann für die meisten Anfragen nutzbare Ausgaben liefern, während er bei jeder Anfrage, die Tabellendaten erfordert, vollständig versagt. Der aggregierte Genauigkeitswert von 98 % erfasst die 100-prozentige Fehlerrate bei tabellenabhängigen Anfragen nicht.
Wenn diese Fehler zentrale Finanzbegriffe, Daten oder Haftungsklauseln betreffen, sind die nachgelagerten Folgen nicht abstrakt.
Aus diesem Grund ist es entscheidend, die Evaluierung gezielt auf die Dokumenttypen und strukturellen Merkmale auszurichten, die für Ihren Anwendungsfall am relevantesten sind. Wenn Ihre Pipeline von der Tabellenextraktion abhängt, testen Sie gezielt die Tabellentreue. Wenn Sie mehrsprachige Dokumente verarbeiten, bewerten Sie die Genauigkeit je Sprache. Wenn Sie für das Chunking auf Abschnittshierarchien angewiesen sind, prüfen Sie, ob Abschnittsgrenzen korrekt identifiziert werden.
Die schwierigen Dokumente zeigen die Obergrenze.
Ein direkter Vergleich liefert das aussagekräftigste Signal. Führen Sie denselben Dokumentensatz durch Ihren aktuellen Parser und durch den zu evaluierenden Parser. Vergleichen Sie anschließend die Ausgaben Seite an Seite anhand der Dimensionen, die für Ihre Pipeline relevant sind.
Im Einzelnen:
- Schritt 1: Wählen Sie einen Benchmark-Satz von 50–100 Dokumenten. Priorisieren Sie komplexe und anspruchsvolle Dokumente aus Ihrem tatsächlichen Corpus – keine einfachen Dokumente.
- Schritt 2: Verarbeiten Sie jedes Dokument mit beiden Tools. Speichern Sie die vollständige Ausgabe für die weitere Evaluierung.
- Schritt 3: Wählen Sie eine Stichprobe von 10–20 Dokumenten aus, um Struktur, Lesereihenfolge und Tabellentreue manuell zu prüfen. Verlassen Sie sich nicht ausschließlich auf Metriken auf Zeichenebene, da diese die strukturellen Fehler, die die Leistung am stärksten beeinträchtigen, nicht sichtbar machen.
- Schritt 4: Führen Sie einen Retrieval-Test durch. Bereiten Sie dafür einen Satz von Fragen mit bekannten Antworten vor, die in Ihren Dokumenten enthalten sind. Indizieren Sie die verarbeitete Ausgabe jedes Tools und prüfen Sie, ob das Retrieval die richtigen Passagen liefert.
- Schritt 5: Vergleichen Sie die Ausgabeformate, um festzustellen, ob das Format Ihres aktuellen Parsers ausreichend semantische Struktur enthält, damit Ihre Chunking-Logik korrekt funktioniert. Ist dies nicht der Fall, ziehen Sie ein Format wie DocLang mit semantischen Labels in Betracht, das nachweislich bessere Chunking- und Retrieval-Ergebnisse ermöglicht.
Das Ziel ist nicht, einen Parser zu finden, der auf einer Rangliste höher platziert ist. Das Ziel ist, einen Parser zu finden, der in Ihrer spezifischen Pipeline mit Ihren spezifischen Dokumenten bessere Ergebnisse liefert.
Der schnellste Weg, die Produktionsobergrenze eines Parsers zu verstehen, besteht darin, ihm zuerst Ihre anspruchsvollsten Dokumente zu übergeben: jene, die aktuell Probleme in Ihrer Pipeline verursachen, die Halluzinationen, beschädigte Tabellen oder eine fehlerhafte Lesereihenfolge erzeugen.
Mit FineParser powered by ABBYY können Sie den Docker-Container herunterladen, ihn auf den Dokumenten ausführen, die bereits Probleme verursachen, und die strukturierte Ausgabe mit dem vergleichen, was Ihr aktueller Parser liefert.
Der Unterschied zwischen dem, was Ihr Parser zurückgibt, und dem, was ein strukturerhaltender Parser liefert, sagt mehr über die Zuverlässigkeitsgrenze Ihrer Pipeline aus als jeder Benchmark-Wert.
Testen Sie ABBYY mit Ihren realen Dokumenten – Early Access ist jetzt verfügbar.

