
2026年8月21日
ベンチマークでは優秀な結果を出しながら、実際の文書では失敗するパーサーは、RAGパイプラインをその起点から汚染してしまいます。ドキュメントパーサーを評価する際には、クリーンなデモだけでなく、現実的で雑然とした文書セットに対してテストを行う必要があります。Gartnerは、AIへの取り組みに関して厳しい現実を予測しています。AIに対応していないデータが原因で、2026年までに組織がAIプロジェクトの60%を断念すると見込まれているのです。本記事では、多くの比較検討で見落とされがちなテストも含め、本番環境向けにドキュメントパーサーをベンチマークする方法を探ります。
パーサーの評価の多くは、最初から問いが間違っています。チームは「どれくらい正確か?」と問いますが、本当に答えるべき問いは「このパーサーが誤った結果を出したとき、パイプラインはどうなるのか?」です。
この問いへの答えは、多くのチームが思うよりもはるかに重要です。LlamaIndexのParseBenchベンチマークによると、現在最も優れたドキュメントパーシングサービスでさえ、エンタープライズ文書ページにおけるコンテンツの忠実度は約90%にとどまっています。これは一見良い数字に思えますが、ハルシネーションやその他のエラーの影響を考えると話が変わります。つまり、エンベディングが一件も生成される前に、クエリが一件も処理される前に、10ページに1ページは意味のある欠落または構造的なエラーを含んでいることを意味します。
取り込み時点でのパーシング品質の低さが、主要な原因のひとつです。
このリスクを特定すべき場所は、本番環境で誤った出力が何週間も出続けた後ではなく、デプロイ前の評価段階です。意味のある比較とは、最良の文書で試した新しいパーサーと、最悪の文書で試した現在のパーサーを対比させることではありません。現実的なパーサー評価は、難しいケースも含めた実際の本番コーパスを反映した文書セットから始まります。
本ガイドは、ベンダーのデモが見せるように設計されたものを追認するのではなく、実際の本番パフォーマンスを予測できる評価を実施するためのフレームワークを提供します。
~へ移動:
クリーンなサンプルファイルを使ったデモは、根拠のない自信を生み出します。
ネイティブPDF、単一カラムのレイアウト、整然とした表を使ったデモは、どのパーサーでも良い結果を出せる条件を提供しています。しかし実際の本番文書コーパスには、そのような条件がほぼ存在しません。
明るさにムラのあるスキャンされた契約書、傾きが生じたFAX送信の請求書、複数の文字体系が混在する多言語の規制文書。こうした文書は評価セットではなく、本番環境に入ってから初めて現れます。
デモのパフォーマンスと本番のパフォーマンスの乖離こそ、検索拡張生成(RAG)パイプラインが破綻する箇所です。パーシングが悪ければチャンクも悪くなります。チャンクが悪ければ検索品質も低下します。検索品質が低ければ、どれほどプロンプトエンジニアリングやモデルチューニングを重ねてもハルシネーションは解消できません。なぜなら、モデルは知識の欠如ではなく、破損した根拠の上で推論しているからです。
CVPR 2025で発表されたOmniDocBenchの研究は、これを直接的に裏付けています。パーサーがクリーンなベンチマーク条件から、現実的で多様な文書セットに移行すると、精度スコアが大幅に低下することが確認されました。評価が実際の文書条件を再現していなければ、得られたスコアも実際の本番結果を反映しません。
パーサーの評価に使用する文書は、組織で日常的に扱われる文書タイプから選ぶ必要があります。テストセットには最低限、以下のものを含めてください。
明確で一貫したフォーマットの文書だけでなく、パーサーが構造的な曖昧さをどのように処理するかも評価してください。これらの文書タイプを含む現実的なテストセットがなければ、評価はデモ条件を測定しているに過ぎず、本番の実態を反映していません。
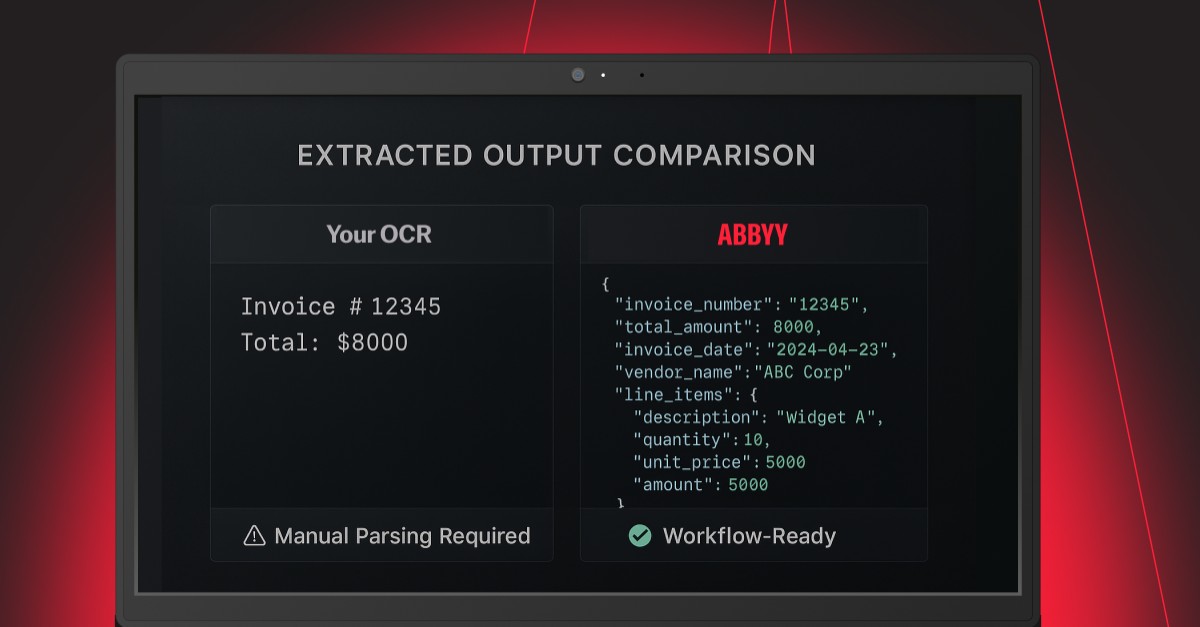
文字レベルの精度、つまり正確に抽出された文字の割合は、パーサーが信頼性の高いRAG検索をサポートできるかどうかをほとんど教えてくれません。文字精度が高くても、下流システムが必要とする情報構造を完全に破壊してしまうパーサーも存在します。
以下の各項目についてテストしてください。
ABBYYがIBM、Nvidia、Red Hat、Linux Foundationと共同で策定したオープンなAIネイティブ文書マークアップ標準であるDocLangのような構造化フォーマットは、見出し、段落、表のセル、脚注、フォームフィールドに対してセマンティックラベルを付与します。その構造こそが、出力を真にAI対応のものにします。 /p>
ラボパフォーマンスとは、精選されたベンチマークでパーサーが出すスコアです。実運用パフォーマンスとは、実際の文書に対して、実際の処理量で、実際の制約のもとでどう動くかです。
| 評価軸 | ラボパフォーマンス | 実運用パフォーマンスにおける主な違い |
| デプロイメントモデル | GPU インフラやクラウド API などの高性能ハードウェアを使用した管理された環境で評価されます。ベンチマーク実施には問題ありませんが、規制が厳しい環境には適さない場合があります。 | CPUのみの環境やエアギャップネットワークなど、現実の制約のもとで機能する必要があります。 |
| 言語・文字体系の対応範囲 | 複数言語にわたる総合精度を重視したデータセットでテストされるのが一般的です。 | 非ラテン文字を含む、文書セットに関連する特定の言語や文字体系での検証が必要です。 |
| エラーの一貫性 | 測定されることはほとんどありません。ベンチマークは平均精度を評価するものであり、障害時の挙動を評価するものではありません。エラーの一貫性が主要な評価軸になることは少ないのが実情です。 | 実際の使用シナリオで管理しやすくするために、予測可能な障害モードが不可欠です。一貫したパフォーマンスを確保するために障害パターンを把握してください。 |
| 大規模処理時の速度 | 個別または小規模な文書セットでパフォーマンスが評価されます。 | 単一文書だけでなく、実際のワークロード条件下で測定され、大量の文書処理におけるスケーラビリティを確認します。 |
最も効果的なパーサーとは、多様な文書タイプにわたって効率的かつ予測可能なデータ構造を生成するものです。その評価においては、セマンティック理解を測るために、単純なOCR精度を超えた視点が必要です。
実際に問題を引き起こす評価結果のカテゴリがあります。「ほとんどの文書では十分に機能する」というものです。
問うべきは、パーサーがクリーンな文書を適切に処理できるかどうかではありません。パイプラインの下流に伝播するエラーを生じさせることなく、コーパス全体を確実に処理できるかどうかです。
「十分に良い」は部分的なエラーの複合効果を見落とします。文書コンテンツの98%を正確に抽出しながら、すべての表を常にフラット化してしまうパーサーは、ほとんどのクエリに対して使用可能な出力を生成しつつ、表データを必要とするクエリに対しては完全に失敗する可能性があります。98%という総合精度の数字は、表に依存するクエリにおける100%の失敗率を捉えていません。
そのエラーが重要な財務用語、日付、または免責条項に関わる場合、下流への影響は決して抽象的なものではありません。
だからこそ、ユースケースにとって最も重要な文書タイプと構造的特徴に絞って評価することが重要です。パイプラインが表の抽出に依存しているなら、表の忠実度を特定的に評価してください。多言語文書を処理するなら、言語ごとの精度を評価してください。チャンキングにセクション階層を利用するなら、セクションの境界が正確に識別されているかを評価してください。
難しい文書こそが、パーサーの限界を明らかにします。
直接比較が最も実用的な判断材料を提供します。同じ文書セットを現在のパーサーと評価対象のパーサーの両方で処理し、パイプラインにとって重要な観点から出力を並べて比較してください。
具体的な手順は以下のとおりです。
目標は、リーダーボードで高スコアを出すパーサーを見つけることではありません。特定のパイプラインで、特定の文書に対して、より良い結果を生み出すパーサーを見つけることです。
パーサーの本番環境での限界を理解する最速の方法は、最も困難な文書から試すことです。現在パイプラインで問題を引き起こしているもの。ハルシネーション、破損した表、または乱れた読み取り順序を生じさせているものです。
ABBYYが提供するFineParserを使えば、Dockerコンテナを取得し、すでに問題を引き起こしている文書で実行して、構造化された出力を現在のパーサーの出力と比較することができます。
現在のパーサーが返す結果と、構造を保持するパーサーが返す結果の差異は、どんなベンチマークスコアよりも、パイプラインの信頼性の限界について多くを語ってくれます。
実際の文書でABBYYをテストしてください。アーリーアクセスを受付中です。
大量の文書を効果的に処理するには、分散コンピューティングとメッセージキューイングシステムを実装してください。ABBYYのFineReader EngineとFineParserは、プライベートクラウドおよびオンプレミスインフラ全体でDockerデプロイをサポートし、自動スケーリングを実現します。
最もリスクの高い文書タイプは、複数カラムのレイアウト、結合セルや罫線なしのセルを持つ表、ノイズや傾きのあるスキャン文書、構造が複数ページにまたがる長い文書、そして非ラテン文字を含む文書です。これらの条件は、ほとんどのパーサーに構造的に誤った出力を生成させ、下流のチャンキングと検索を破損させます。
パーシング品質は、RAGパイプラインのすべての下流段階における精度の下限を決定します。パーサーが誤った読み取り順序、フラット化された表、または欠落したコンテンツを生成すると、その出力から派生するチャンクは破損した根拠を持ちます。モデルはその誤ったコンテキストに基づいて自信を持って回答を生成し、知識の欠如によるハルシネーションと同じ結果をもたらしますが、その原因は取り込みレイヤーに起因しています。パーサーを修正することで、検索戦略やモデルを変更することなく、ハルシネーションの主要な原因を取り除くことができます。
RAGおよびエージェント型AIワークフローにおいては、構造化されたセマンティックフォーマットが不可欠です。プレーンなMarkdownや生テキストは、検索の信頼性を支える構造情報を取り除いてしまいます。DocLangのようなフォーマットは、見出し、段落、行列位置を持つ表のセル、脚注、フォームフィールドを含むすべてのコンテンツ要素にセマンティックラベルを付与します。DocLangは、AIによる文書利用のために特別に設計された、ABBYY、IBM、Nvidia、Red Hat、Linux Foundationが共同で策定したオープンスタンダードです。セマンティックラベリングを持つJSON、ALTO、XMLも、正確なチャンキングと検索をサポートする構造を保持します。
シンプルな単一カラムのネイティブテキストPDFであれば、軽量なパーサーで十分な場合もあります。しかし、スキャン文書、複数カラムのレイアウト、表、または多言語コンテンツを含むコーパスに対しては、Tesseractのようなオープンソースツールは精度の上限を設けてしまい、検索品質を直接制限します。オープンソースツールは、現実的なエンタープライズ文書セットに対して、その上限を大幅に下回るパフォーマンスを示すことが一般的です。目的に合わせて構築されたエンタープライズグレードのソリューションに投資することで、優れたパフォーマンス、保守性、そして長期的な目標との整合性を確保できます。
FineParserのような、本番の実態に即したデプロイメントモデルは、構造、表、レイアウト、テキストを網羅した完全な文書忠実度スタックをひとつのコンテナで提供します。マイクロサービスの乱立も、外部への呼び出しも不要です。
FineParserは、AI向けに設計されたモダンなコンテナ化デプロイメントモデルです。その仕組みをご確認ください。
意味のある評価には、実際のコーパスから抽出した最低50〜100件の文書が必要であり、最も複雑で問題のある文書タイプを重点的に含める必要があります。より少ない文書でテストしたり、本番の平均よりクリーンな文書でテストしたりすると、本番の結果を予測できない精度スコアが生成されます。現在パイプラインで問題を引き起こしている文書こそが、あらゆる評価の出発点であるべきで、クリーンな例は出発点
表の忠実性は、多くの場合、最も多くを明らかにするテストです。なぜなら、これは大半のパーサーが最もうまく処理できない構造的特徴であり、なおかつ後工程の精度にとって最も重要だからです。表の内容が出力に現れるかどうかだけでなく、行と列の関係が保持されているかどうかを評価してください。
検索拡張生成(RAG)に、あらゆる場面に対応できる万能なドキュメントパーサーは存在しません。最良のパーサーは、データ形式、処理のニーズ、拡張性の要件といった要素によって変わります。問うべきは「どれが最良か」ではなく、「私のドキュメントで、私の規模で、私の制約のもとで、どれが最も高い性能を発揮するか」です。FineParserを実際のドキュメントで試してみてください。お好みの言語で解析し、ご自身のインフラ上で数分のうちに実行できます。自社のスタックを自ら管理するチームのために構築されたドキュメントパーサーへ、早期アクセスを手に入れてください。

Dr. Marlene Wolfgruber
ABBYY AI戦略担当ディレクター
マルレーネ・ヴォルフグルーバー博士は、製品管理と製品マーケティングにおいて10年以上のリーダーシップ経験を持っています。インテリジェント自動化業界における幅広いテーマに深い知見を有し、AIおよび言語技術の専門家として、その知識を定期的に発信しています。以前の役職では、マルレーネはAIを活用した支出管理の革新を主導し、生成AIによる自律型アシスタントの構築を通じて企業を支援してきました。ミュンヘンのルートヴィヒ・マクシミリアン大学で計算言語学の博士号を取得しており、読書、運動、料理、そして2人のお子さんと過ごす時間を楽しんでいます。
鋭い洞察をお求めの方は、LinkedInでマルレーネ・ヴォルフグルーバー博士をフォローしてください。
ABBYYのマルレーネとマックスが共同ホストを務めるAI Pulse Podcastは、ビジネスおよびテクノロジーのリーダーに向けて幅広いテーマを取り上げ、AIが私たちの働き方をどのように変えつつあるかに焦点を当てています。お使いのポッドキャストサービスでぜひお聴きください。YouTube、Spotify、Apple Podcastsでご利用いただけます。
どうぞお楽しみください。https://linktr.ee/AIPulsePodcast