精度
実際のビジネス文書における本物の精度
エンタープライズ文書とは、スキャンされた契約書、多言語フォーム、複雑な表を含む財務レポートです。FineParserは、あらゆる形式、あらゆるエッジケースを本番環境で解決してきた35年以上の実績の上に構築されています。
ABBYY FineParser
お客様のインフラ内で稼働するエンタープライズ向け文書解析ソリューション。高い精度と構造化された出力により、初日からAIワークフローに対応します。
FineParserは、AIワークフローを統合する開発者のために特別に構築された、エンタープライズグレードの文書解析インフラです。文書を取り込むあらゆるAIパイプラインにおける、最初のステップを担います。
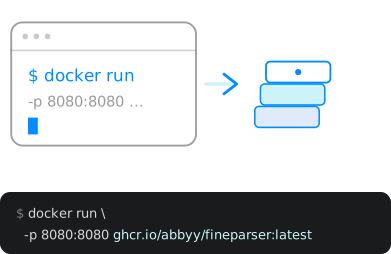
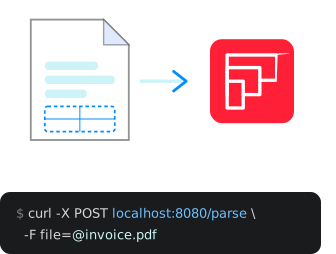
他のパーサーがスキャンされた表や複雑な段組みレイアウトを持つビジネス文書で限界を迎える場面でも、FineParserは確実に機能します。クリーンなREST APIを通じて、DocLang、JSON、ALTO、XMLなど、AI対応の構造化された形式に文書を変換します。標準的なCPUハードウェア上で動作し、Dockerコンテナを通じてオンプレミスまたは任意のクラウド環境にデプロイ可能です。外部へのデータ転送は不要です。*
AIエージェントや自動化ワークフローの信頼性は、その基盤となるデータの品質に依存します。あらゆるエージェント型パイプライン、RAGシステム、文書自動化ワークフローは、実際のビジネス文書から構造化された正確なコンテンツを取り出すという、同じステップから始まります。多くのパイプラインが静かに破綻するのは、まさにこのステップです。FineParserは、デモ環境だけでなく本番環境でそのステップを確実に機能させる必要があるチームのために構築された、文書解析レイヤーです。
エンタープライズ文書とは、スキャンされた契約書、多言語フォーム、複雑な表を含む財務レポートです。FineParserは、あらゆる形式、あらゆるエッジケースを本番環境で解決してきた35年以上の実績の上に構築されています。
表の構造を保持し、読み取り順序を維持し、論理的な階層構造を守る。FineParserは、下流でのハルシネーションを引き起こす推測の余地を排除する、完全なセマンティック出力を提供します。
FineParserはすべての文書をお客様のインフラ内で完結処理します。外部への送信は一切ありません。データ主権がオプションではなくコンプライアンス上の要件である組織のために設計されています。
文書解析レイヤーはパイプラインに組み込まれ、継続的に依存される基盤的な存在です。FineParserはABBYYの35年以上にわたるエンタープライズ信頼性に裏付けられ、長期的な運用を見据えて構築されています。
FineParserは、TIFF、JPEG、PDFなどの標準的な入力形式において、スキャン文書とデジタル作成文書の両方を受け付けます。認識処理が始まる前に、エンジンは傾き補正、2値化、ノイズ除去、回転補正などの画像強調処理を自動的に適用し、低品質なスキャン、劣化したオリジナル、撮影された文書における認識精度を最大化します。このステップにより、ソース文書の取得方法にかかわらず、認識パイプラインに可能な限りクリーンな信号が渡されることを保証します。
ECMシステム、文書のイメージングおよびキャプチャソリューション、RPAプラットフォームの主要プロバイダー、ならびに世界中のスキャナーおよびMFPメーカーから信頼されているOCR技術、ABBYY FineReader Engineを基盤として構築されています。


FineParserはAIベースのアルゴリズムとABBYYの適応型文書認識技術(ADRT)を活用し、各ページのレイアウトと文書全体の論理構造を分析します。テキスト領域を特定し、読み取り順序を検出し、表の位置を特定して、文書の論理的な階層構造を再構築します。その構造マップに基づいて、光学文字認識(OCR)が208言語・文字体系(CJK、アラビア語、ヘブライ語、インド系言語、タイ語を含む)にわたって商用グレードの精度で処理を実行します。同じパイプラインが手書き文字(ICR)、チェックマークやフォームマーク(OMR)、バーコード(OBR)も処理します。出力は文書の完全な構造化表現です。
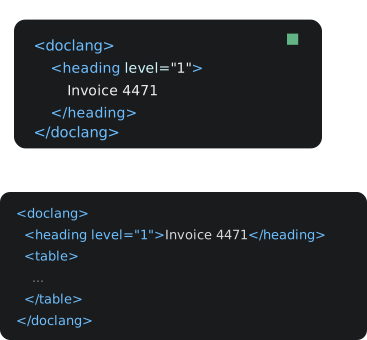
FineParserは、下流パイプラインが必要とする形式で文書の完全な構造化表現を出力します。出力形式には、AI対応文書表現のための唯一のAIネイティブオープン文書標準であるDocLang、ならびにJSON、ALTO、XMLが含まれます。アーカイブおよびコンプライアンスワークフロー向けに、検索可能なPDFとPDF/Aも利用できます。
すべての出力は、ステップ2の構造的な結果をそのままパイプラインに引き継ぎます。表、段組みレイアウト、読み取り順序、論理的な階層構造、書式設定がすべて保持されます。DocLangで出力する場合、出所情報、メタデータ、構造的なコンテキストといった文書ガバナンス情報も合わせて取得され、下流ワークフローへと引き継がれます。RAGパイプライン、エージェント、またはLLMアプリケーションに渡されるのは、ソース文書の完全かつ構造的に正確な表現です。

標準的なCPUハードウェア上で動作し、オンプレミスまたは任意のクラウドにデプロイ可能です。追加調達は不要です。

CJK、アラビア語、インド系言語、キリル文字、ラテン文字など、グローバルなすべての文書を一つのデプロイで処理します。

罫線なしの表、結合セル、段組みレイアウトにも対応し、完全な構造と読み取り順序を一貫して保持します。

低品質のスキャン、劣化したオリジナル、撮影された文書も自動処理します。手動での前処理は不要です。

印刷文字、手書き文字、フォームマーク、バーコードを、別サービスなしで単一ワークフローで処理します。

すべての文書はお客様のインフラ内で完結処理されます。ABBYYや第三者へのデータ送信は一切行われません。

Enterprise/FineReader Engine のアドオンにより、PDF/A アーカイブ準拠と高圧縮 PDF/MRC 機能を追加。


検索拡張生成(RAG)に適したドキュメントパーサーを選ぶには、デプロイ要件と制約を慎重に評価する必要があります。クラウド専用の解析は多くの一般的なユースケースに適していますが、特定のシナリオでは制約要因となる場合があります。

検索拡張生成(RAG)に適したドキュメントパーサーを選ぶには、デプロイ要件と制約を慎重に評価する必要があります。クラウド専用の解析は多くの一般的なユースケースに適していますが、特定のシナリオでは制約要因となる場合があります。
FineParserの運用についてご質問はありますか。お気軽にお問い合わせください。最適な答えを一緒に見つけます。
*セルフサービスプランでは、ページ数の確認のみを目的として、ABBYYのライセンスサーバーへの定期的なアウトバウンド接続が必要です。文書データは送信されません。アウトバウンド接続のない完全なエアギャップ環境へのデプロイには、ABBYY FineReader Engine Enterpriseライセンスが必要です。
**外部への接続性が一切ない完全にエアギャップ環境の導入には、ABBYY FineReader Engine Enterprise ライセンスが必要です。
検索拡張生成(RAG)に適したドキュメントパーサーを選ぶには、デプロイ要件と制約を慎重に評価する必要があります。クラウド専用の解析は多くの一般的なユースケースに適していますが、特定のシナリオでは制約要因となる場合があります。
